随机模拟从均匀随机数出发,经分布变换得到目标样本,再用样本计算期望或驱动随机过程:
$$ \text{均匀随机数} \longrightarrow \text{目标分布} \longrightarrow \text{期望与误差} \longrightarrow \text{随机过程} \longrightarrow \text{SDE 的数值解}. $$前半段讨论样本的生成与估计精度,后半段讨论连续时间模型的离散计算。判断算法时,需要同时看分布是否正确、误差能否量化,以及计算成本。
本文将 Stochastic Simulation 与 NASODE 的材料重新组织为三个部分:随机数与误差控制、不同抽样方法,以及 SDE 的数值计算。
后文会区分抽样误差、时间离散误差、截断误差与 Markov 链未收敛造成的误差。每个小节附有一个浏览器端数值实验,可直接修改参数。
1. 随机模拟:随机数、估计与误差控制
1.1 伪随机数是怎样生成的
计算机首先产生的通常不是任意分布,而是一串看起来像独立均匀变量的伪随机数
$$ U_1,U_2,\ldots\sim U(0,1). $$伪随机数生成器是确定性状态机:
$$ s_{n+1}=T(s_n),\qquad U_n=G(s_n). $$固定随机种子(seed)可以复现实验。长周期只能避免序列过早重复,不能排除相邻输出中的结构。线性同余生成器
$$ x_{n+1}=(ax_n+c)\bmod M,\qquad u_n=x_n/M $$即使参数使周期达到 $M$,连续点对 $(u_n,u_{n+1})$ 仍可能落在少数平行直线上。一维 Kolmogorov–Smirnov 检验也看不到这种序列相关性。实际计算宜使用成熟数值库的生成器,并保存随机种子、算法和库版本。
对混合型线性同余生成器,Hull–Dobell 条件给出了完整周期的充要条件:
- $\gcd(c,M)=1$;
- $M$ 的每个素因子都整除 $a-1$;
- 若 $4\mid M$,则 $4\mid(a-1)$。
这些条件只回答“什么时候回到初始状态”。它们不回答点集在二维或更高维空间是否均匀。对生成器做检查时,应区分三层:一维边际是否均匀、滞后相关是否接近零、高维连续元组是否出现格结构。某个检验没有拒绝均匀性,只表示当前样本没有提供足够反证,并不等于“生成器已被证明随机”。
修改线性同余生成器的参数,观察相邻点 $(u_n,u_{n+1})$ 是否形成格线。
周期长不等于高维点集均匀;尝试把模数改小,格结构会更明显。
1.2 如何估计积分和误差
从概率与积分到样本均值
Monte Carlo 的基本动作是把目标量写成期望。若要计算事件 $A$ 的概率,可以使用指示变量
$$ \mathbf 1_A(X)= \begin{cases} 1,&X\in A,\\ 0,&X\notin A. \end{cases} $$因为
$$ \mathbb P(X\in A)=\mathbb E[\mathbf 1_A(X)], $$事件概率的 Monte Carlo 估计就是样本落入 $A$ 的比例:
$$ \widehat p_N =\frac1N\sum_{i=1}^N\mathbf 1_A(X_i). $$概率由概率测度定义。对连续分布、非均匀分布或无穷样本空间,它一般不是事件集合与总体集合的几何容量之比。
积分同样可以写成期望。若 $X$ 的密度为 $f$,则
$$ I=\int h(x)f(x)\,dx=\mathbb E[h(X)]. $$生成独立样本 $X_1,\ldots,X_N$ 后,用样本均值
$$ \widehat I_N=\frac1N\sum_{i=1}^N h(X_i) $$估计 $I$。只要 $\mathbb E[h(X)^2]\lt\infty$,
$$ \mathbb E[\widehat I_N]=I,\qquad \operatorname{Var}(\widehat I_N)=\frac{\sigma^2}{N}, \quad \sigma^2=\operatorname{Var}(h(X)). $$因此标准误差按 $N^{-1/2}$ 下降:想把误差减半,通常要把样本量扩大四倍。它的优势是收敛阶不显式依赖维数;规则网格在 $p$ 维上若每个方向取 $n$ 点,总点数是 $N=n^p$,网格宽度只按 $N^{-1/p}$ 缩小。
Monte Carlo 在低维时未必占优。对二阶连续可导的一维函数,复合梯形公式的误差通常为 $O(n^{-2})$,比 Monte Carlo 的 $O(n^{-1/2})$ 快;但把张量积梯形公式推广到 $d$ 维、并以总计算点数 $N$ 计量时,其典型误差阶变为 $O(N^{-2/d})$。维数增加后,确定性网格的优势迅速减弱,而 Monte Carlo 的基本抽样阶仍是 $O(N^{-1/2})$。
标准误、置信区间与适用条件
误差分析用到两条极限定理。若 $\mathbb E|h(X)|\lt\infty$,强大数定律给出
$$ \widehat I_N\xrightarrow{\mathrm{a.s.}}I. $$强大数定律保证估计量最终收敛,但不给出有限 $N$ 时的误差。若进一步有 $0\lt\sigma^2\lt\infty$,中心极限定理给出
$$ \sqrt N\, \frac{\widehat I_N-I}{\sigma} \xrightarrow{d}N(0,1). $$中心极限定理给出了常用标准误和正态置信区间的依据。对事件概率,单个指示变量的方差为 $p(1-p)$,所以
$$ \operatorname{SE}(\widehat p_N) =\sqrt{\frac{p(1-p)}N}. $$当 $p$ 很小且 $Np$ 不大时,正态近似会很差,也正是稀有事件模拟需要重要性采样的原因。
未知的 $\sigma$ 用样本方差
$$ S_N^2=\frac1{N-1}\sum_{i=1}^N\bigl(h(X_i)-\widehat I_N\bigr)^2 $$估计。中心极限定理给出近似置信区间
$$ \widehat I_N \pm z_{1-\alpha/2}\frac{S_N}{\sqrt N}. $$这个区间描述重复抽样时估计量的波动;它不是对某一次计算误差的确定性上界。当 $h(X)$ 尾部很重、方差不存在,或样本之间相关时,上式可能严重误导。
误差来源与计算成本
比较两个无偏 Monte Carlo 方法时,不能只比较单样本方差。如果方法 A 的单次样本方差是 $v_A$、平均成本是 $c_A$,在总预算 $B$ 下大约能生成 $B/c_A$ 个样本,最终方差约为
$$ \frac{v_Ac_A}{B}. $$因此可用下面的量比较计算效率:
$$ \text{inefficiency} =\operatorname{Var}(\text{单次输出}) \times \mathbb E[\text{单次计算时间}]. $$方差缩减若付出了过高计算成本,整体未必更快。计时时需要包含生成随机数、计算权重和模型求解的总成本,并在相同硬件和实现条件下比较。
若估计量还带有偏差,均方误差可分解为
$$ \operatorname{MSE}(\widehat I) =\bigl(\mathbb E[\widehat I]-I\bigr)^2 +\operatorname{Var}(\widehat I). $$直接 Monte Carlo 没有抽样偏差,但离散 SDE、截断无穷级数或未收敛的 Markov 链会引入偏差。报告误差时要先说明误差来自哪一层,再决定应增加样本数、减小时间步长,还是改变算法。
用重复实验检查误差估计
以积分
$$ I=\int_0^1 e^{-x^2}\,dx $$为例。令 $U_i\sim U(0,1)$,则
$$ \widehat I_N=\frac1N\sum_{i=1}^N e^{-U_i^2}. $$每个样本都落在 $[e^{-1},1]$,方差有限,中心极限定理适用。计算结果应同时给出 $N$、样本标准差、标准误和置信区间。例如:
u = rng.random(n)
y = np.exp(-u**2)
estimate = y.mean()
standard_error = y.std(ddof=1) / np.sqrt(n)
interval = estimate + np.array([-1, 1]) * 1.96 * standard_error
把 $N$ 扩大四倍,标准误理论上约减半。用多个独立随机种子重复实验时,估计量的经验标准差应接近单次实验报告的标准误;两者的差异可用于检查误差计算。
有限方差是使用上述误差公式的前提。若 $Y=h(X)$ 的尾部使 $\mathbb E[Y^2]=\infty$,样本方差会被极少数观测主导,常见的 $1/\sqrt N$ 误差条便失去依据。此时需要先研究尾部,再考虑变量变换、重要性采样、截尾估计或适用于重尾分布的极限定理。
为什么高维问题偏爱 Monte Carlo
高维问题是 Monte Carlo 的典型应用。例如路径依赖衍生品的收益依赖
$$ S_{t_1},S_{t_2},\ldots,S_{t_m}, $$把期望写成积分后,维数随时间点数 $m$ 增加。确定性张量网格的点数随维数指数增长,而 Monte Carlo 的 $N^{-1/2}$ 抽样阶不显式含 $m$。维数仍会影响被积函数方差、单条路径成本和 MCMC 的混合速度。
用 Monte Carlo 估计 $I=\int_0^1 e^{-x^2}\,dx$,并用重复实验检验标准误和 95% 区间。
图中红线是首轮运行均值,浅色边界是估计的 95% 区间,绿线是参考真值。
1.3 如何降低模拟误差
增加样本数只利用了 $N^{-1/2}$ 的基本规律。方差缩减则试图让单个样本携带更多信息。
对偶变量
若 $U\sim U(0,1)$,那么 $1-U$ 也服从同一分布。把
$$ \widehat I_{\mathrm{anti}} =\frac1N\sum_{i=1}^{N/2} \bigl[h(U_i)+h(1-U_i)\bigr] $$作为估计量,在 $h$ 单调时,两项通常负相关,方差中的协方差项因而降低。对偶变量计算便宜;若配对后的相关性不为负,则未必有改善。
控制变量
假设随机变量 $C$ 的均值 $\mu_C$ 已知。令
$$ \widehat I_c =\frac1N\sum_{i=1}^N \left[h(X_i)-c(C_i-\mu_C)\right]. $$它仍然无偏。最优系数为
$$ c^\star= \frac{\operatorname{Cov}(h(X),C)} {\operatorname{Var}(C)}, $$此时方差缩小为原来的 $1-\rho^2$,其中 $\rho$ 是二者的相关系数。控制变量越接近目标量,收益越大。
重要性采样
若从 $f$ 直接采样难以观察到决定积分的区域,可改从 $g$ 采样:
$$ I=\mathbb E_g\!\left[ h(Y)\frac{f(Y)}{g(Y)} \right]. $$它对稀有事件尤其有效,但要求 $g(x)>0$ 覆盖所有 $h(x)f(x)\ne0$ 的区域。权重
$$ w(Y)=\frac{f(Y)}{g(Y)} $$若高度集中在少数样本上,估计会变得不稳定。判断结果时需要同时查看权重分布、有效样本量和样本均值。
准 Monte Carlo
准 Monte Carlo 用低差异点替代随机点。对足够规则的被积函数,误差可接近
$$ O\!\left(\frac{(\log N)^{d-1}}{N}\right), $$该误差阶依赖函数变差和维数;随机化低差异序列更便于同时获得方差估计。
如何选择并验证方法
方法取决于问题中的结构:单调性可用于构造对偶变量,已知期望的相近量可作控制变量,稀有区域适合重要性采样,低有效维数且平滑的问题可尝试准 Monte Carlo。
若每一对变量为 $(Y,Y')$,对偶估计量的单对方差是
$$ \operatorname{Var}\!\left(\frac{Y+Y'}2\right) =\frac12\operatorname{Var}(Y) +\frac12\operatorname{Cov}(Y,Y'). $$只有协方差为负时才优于两个独立样本。控制变量则有
$$ \operatorname{Var}(Y-cC) =\operatorname{Var}(Y) -2c\operatorname{Cov}(Y,C) +c^2\operatorname{Var}(C), $$对 $c$ 求导就得到最优 $c^\star$。计算时可先用一小批预实验样本估计 $c^\star$,再在主样本中固定它,避免忽略系数拟合带来的波动。
稀有事件展示了无偏估计仍可能很不稳定。令
$$ p=\mathbb P(Z>a),\qquad Z\sim N(0,1). $$直接模拟的单样本是 $\mathbf 1_{\{Z>a\}}$,相对标准误约为
$$ \sqrt{\frac{1-p}{Np}}. $$当 $p$ 极小时,大多数实验一次成功事件都看不到。可以改从均值右移的正态分布 $N(\mu,1)$ 采样,并乘似然比
$$ w(y)=\frac{\phi(y)}{\phi(y-\mu)}. $$若 $\mu$ 把样本集中到阈值附近,方差会显著下降;若移动过头,少数巨大权重又会主导结果。可根据权重变异和预实验结果调整提议分布参数。
在相近函数计算次数下估计 $\int_0^1 e^x\,dx$,比较直接抽样、对偶变量和控制变量。
柱越短,估计越稳定。控制变量使用已知均值 $\mathbb E[U]=1/2$。
2. 不同抽样方法:如何从目标分布得到样本
2.1 什么时候使用逆变换、拒绝采样或正态变换
逆变换法
分位数法把均匀变量直接映射到目标分布。对任意分布函数 $F$,定义广义逆
$$ F^{-1}(u)=\inf\{x:F(x)\ge u\}. $$若 $U\sim U(0,1)$,则 $X=F^{-1}(U)$ 服从 $F$,因为
$$ \mathbb P(F^{-1}(U)\le x)=\mathbb P(U\le F(x))=F(x). $$例如 $X\sim\operatorname{Exp}(\lambda)$ 可以写成
$$ X=-\frac{1}{\lambda}\log(1-U). $$广义逆也适用于离散分布:把 $U$ 放入累计概率划分出的区间即可。
以取值 $x_1\lt x_2\lt\cdots\lt x_K$、概率 $p_1,\ldots,p_K$ 的离散变量为例,先计算
$$ c_k=\sum_{j=1}^k p_j. $$然后取满足 $c_{k-1}\lt U\le c_k$ 的最小 $k$,输出 $x_k$。当 $K$ 很大且同一分布需要重复采样时,可以对累计概率做二分查找;若概率表固定且采样量极大,还可预处理 alias table,将单次采样降为常数时间。这里算法改变的是查找成本,不改变分位数变换的概率原理。
拒绝采样
若 $F^{-1}$ 难以计算,可以使用拒绝采样。设目标密度为 $f$,容易采样的提议密度为 $g$,并且
$$ f(x)\le M g(x). $$先生成 $Y\sim g$ 和 $U\sim U(0,1)$,当
$$ U\le \frac{f(Y)}{Mg(Y)} $$时接受 $Y$。每个候选被接受的概率是 $1/M$,而接受后 $Y$ 的条件密度正是 $f$。平均得到一个样本需要生成 $M$ 个候选。若 $g$ 的支撑没有覆盖 $f$,或者尾部过轻使 $\sup_x f(x)/g(x)=\infty$,该方法便不能使用。
正确性可以直接由条件概率看出。对任意可测集合 $A$,
$$ \begin{aligned} \mathbb P(Y\in A,\text{ accept}) &=\int_A g(y)\frac{f(y)}{Mg(y)}\,dy\\ &=\frac1M\int_A f(y)\,dy. \end{aligned} $$取 $A$ 为整个空间,得到 $\mathbb P(\text{accept})=1/M$;两式相除便有
$$ \mathbb P(Y\in A\mid\text{accept}) =\int_A f(y)\,dy. $$例如用 $U(0,1)$ 提议分布生成 $\operatorname{Beta}(2,5)$。目标密度
$$ f(x)=30x(1-x)^4,\qquad 0\lt x\lt1 $$在 $x=1/5$ 处达到最大值 $M=2.4576$,所以理论接受率是 $1/M\approx0.4069$。程序得到 $0.4076$。理论接受率与经验接受率若持续不符,通常需要检查密度常数、支撑或接受条件。
Box–Muller 与相关正态变量
标准正态变量可以由 Box–Muller 变换生成。若 $U_1,U_2$ 独立且均匀,则
$$ \begin{aligned} Z_1&=\sqrt{-2\log U_1}\cos(2\pi U_2),\\ Z_2&=\sqrt{-2\log U_1}\sin(2\pi U_2) \end{aligned} $$是两个独立的 $N(0,1)$ 变量。进一步,若 $Z\sim N(0,I_d)$ 且 $\Sigma=AA^\mathsf T$,则
$$ X=\mu+AZ\sim N(\mu,\Sigma). $$同一变换也用于生成相关正态变量和多维 Brownian 增量。
Box–Muller 的来源是二维标准正态的旋转对称性。把 $(Z_1,Z_2)$ 写成极坐标
$$ Z_1=R\cos\Theta,\qquad Z_2=R\sin\Theta. $$Jacobian 带来一个因子 $r$,联合密度因而分解为
$$ \frac1{2\pi}e^{-r^2/2}r =\frac1{2\pi}\cdot re^{-r^2/2}. $$所以 $\Theta\sim U(0,2\pi)$,而 $R^2\sim\chi_2^2=\operatorname{Exp}(1/2)$。分别对角度和半径作逆变换,就得到上面的公式。实现时必须避免对 $U_1=0$ 取对数;调用成熟库时还应明确返回的是哪一种正态生成算法,因为改变库版本后,相同 seed 不一定继续产生相同正态序列。
对多元正态变换,有
$$ \mathbb E[X]=\mu,\qquad \operatorname{Cov}(X) =A\operatorname{Cov}(Z)A^\mathsf T =AA^\mathsf T=\Sigma. $$若 $\Sigma$ 正定,可取 Cholesky 因子;若只半正定,则需要特征值分解并去掉数值上为负的小特征值。把矩阵方向写成 $A^\mathsf TZ$ 会在一般情况下生成错误的协方差,这是实现中很常见的失误。
如何验证抽样程序
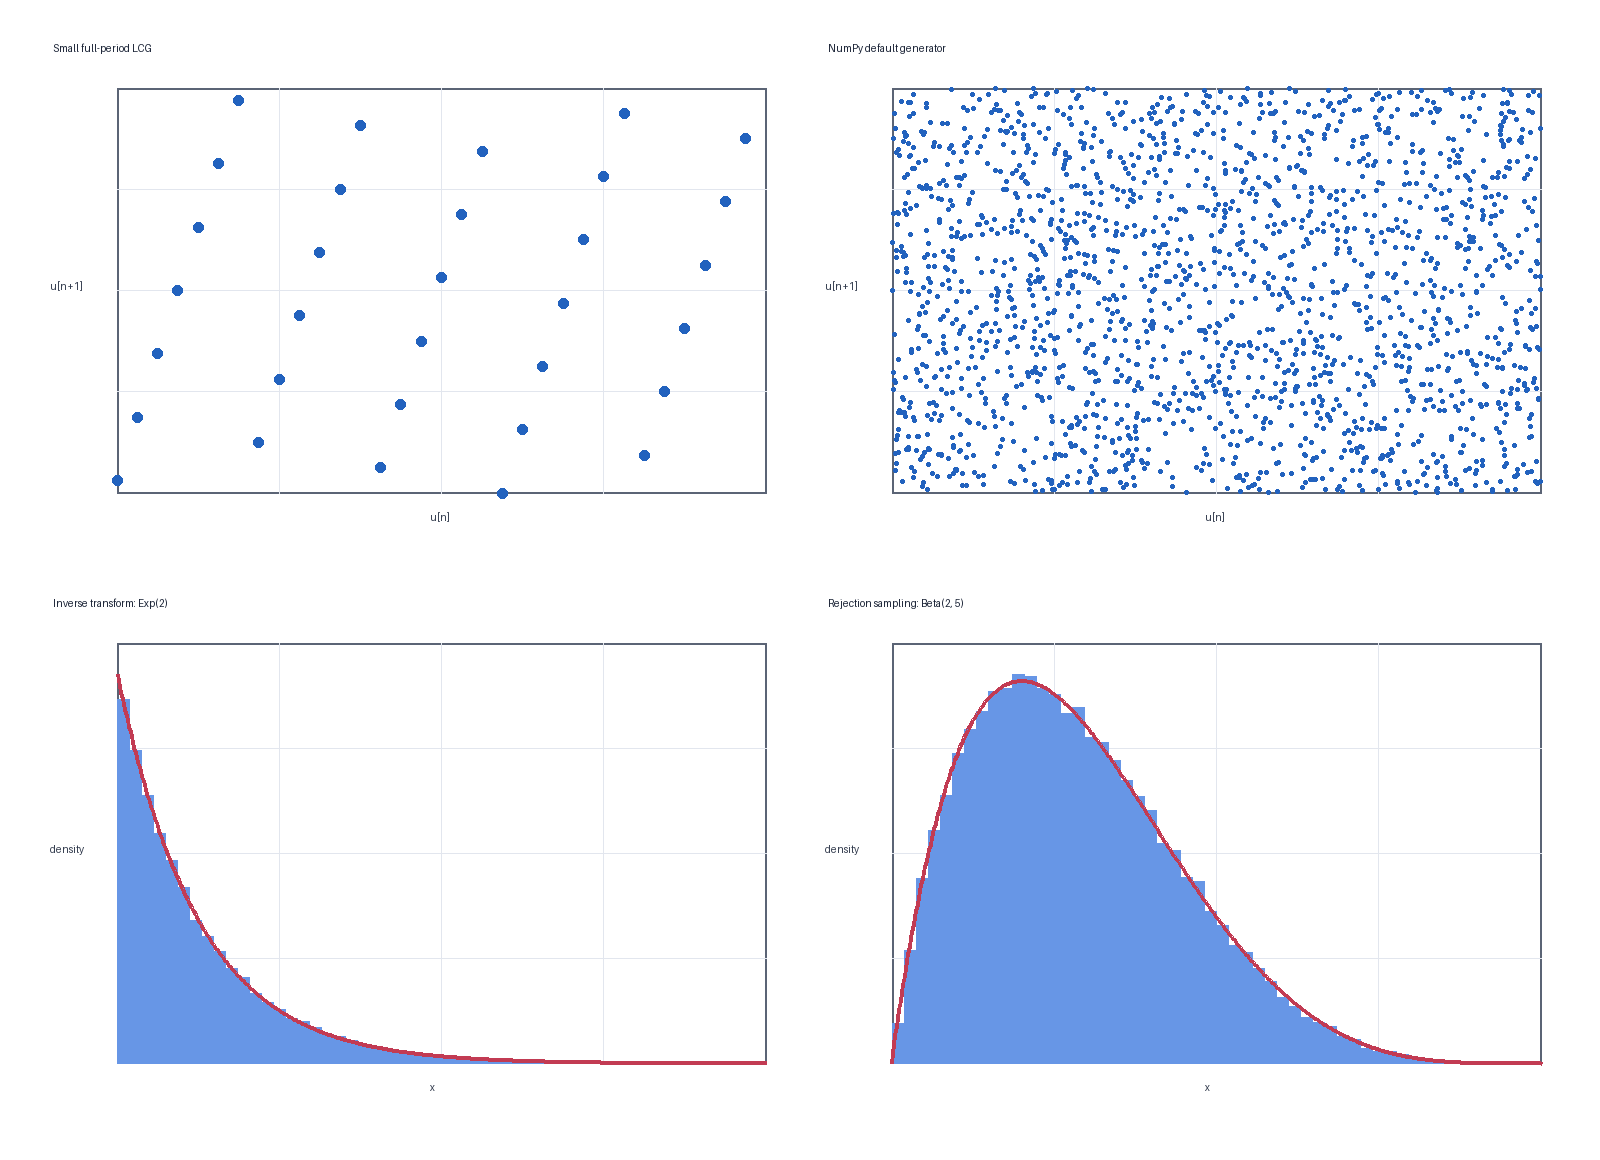
配套的 Python 示例用固定 seed 生成 $50\,000$ 个样本,得到:
| 分布 | 理论值 | 模拟值 |
|---|---|---|
| $\operatorname{Exp}(2)$ 均值、方差 | $0.5,\ 0.25$ | $0.4998,\ 0.2492$ |
| $\operatorname{Beta}(2,5)$ 均值、方差 | $0.2857,\ 0.0255$ | $0.2853,\ 0.0252$ |
| $N(0,1)$ 均值、方差 | $0,\ 1$ | $-0.0034,\ 1.0076$ |
矩、直方图和接受率可发现明显错误。进一步的检查包括更换随机种子重复实验、检验联合分布,以及核对支撑和协方差等算法不变量。
选择目标分布,程序会使用逆变换、拒绝采样或 Box–Muller 生成样本。
直方图应贴近理论密度;拒绝采样还会报告经验接受率。
2.2 如何从复杂分布采样并诊断 MCMC
Metropolis–Hastings 的基本机制
复杂高维分布往往只有未归一化密度
$$ \pi(x)=\frac{\widetilde\pi(x)}{Z}, $$而归一化常数 $Z$ 难以计算。MCMC 不要求样本独立,而是构造以 $\pi$ 为不变分布的 Markov 链。若链遍历充分,则
$$ \frac1N\sum_{n=1}^N h(X_n) \longrightarrow \mathbb E_\pi[h(X)]. $$Metropolis–Hastings 从当前位置 $x$ 按 $q(x,\cdot)$ 生成候选值 $y$,以概率
$$ \alpha(x,y)= \min\!\left\{ 1,\, \frac{\widetilde\pi(y)q(y,x)} {\widetilde\pi(x)q(x,y)} \right\} $$接受。$Z$ 在比值中消去。对称随机游走的 $q$ 也会消去,但步长过小时链移动缓慢,过大时拒绝率又会升高。
接受概率来自详细平衡条件。记转移核的非对角部分为
$$ P(x,dy)=q(x,y)\alpha(x,y)\,dy. $$则
$$ \pi(x)q(x,y)\alpha(x,y) =\min\{\pi(x)q(x,y),\pi(y)q(y,x)\} $$关于 $x,y$ 对称,因此
$$ \pi(dx)P(x,dy)=\pi(dy)P(y,dx). $$详细平衡蕴含 $\pi$ 不变。要让长期平均收敛到目标期望,链还需能从初值到达目标分布的各个重要区域,并避免周期性。若提议分布无法跨过两个模式之间的低密度区,即使接受率正常,样本也可能只代表其中一个模式。
随机游走 Metropolis 的一步可以写成
给定当前状态 x
生成 y = x + τz,z ~ N(0, I)
计算 log α = min(0, log π̃(y) - log π̃(x))
若 log U ≤ log α,则令下一状态为 y;否则仍为 x
在 log 尺度计算可以避免高维密度连乘造成的下溢。拒绝时必须把当前位置再次记录为一个样本;若只保存接受的候选值,得到的是另一条链,通常不再以 $\pi$ 为不变分布。
如何改进提议分布
几种改进对应不同结构:
| 方法 | 核心动作 | 适用情形 |
|---|---|---|
| 分量更新 | 每次只更新一部分坐标 | 各方向尺度差异大 |
| Gibbs | 从全条件分布直接抽样,接受率为 1 | 全条件易采样 |
| HMC | 用梯度和近似 Hamilton 动力学提出远距离候选 | 连续、高维、密度可微 |
| 重参数化 | 改变变量尺度或减少后验几何相关性 | 漏斗形、强相关模型 |
HMC 在扩展状态 $(x,u)$ 上使用
$$ \widetilde\pi(x,u)\propto \pi(x)\exp\!\left(-\frac12u^\mathsf TM^{-1}u\right), $$用 leapfrog 离散 Hamilton 方程,再通过一次 Metropolis 校正消除离散误差。
如何判断 Markov 链是否可靠
诊断关注链是否探索了目标分布的各个重要区域。相关样本均值的渐近方差为
$$ \sigma_\infty^2 =R(0)+2\sum_{k=1}^{\infty}R(k), $$其中 $R(k)$ 是滞后 $k$ 的自协方差。正相关会使有效样本量远小于迭代次数。常用检查包括:
- 从分散初值运行多条链;
- 检查 trace plot 是否跨越相同区域;
- 用 $\widehat R$ 比较链内与链间变异;
- 报告有效样本量和基于批均值的 Monte Carlo 标准误;
- 对关键统计量重复检查,而不是只诊断参数均值。
burn-in 只能减少初始状态的影响,不能修复混合缓慢或模式遗漏。简单 thinning 通常也不会增加已有计算中的信息量。
自相关可以进一步量化为积分自相关时间
$$ \tau_{\mathrm{int}} =1+2\sum_{k=1}^\infty \rho(k), $$以及有效样本量
$$ N_{\mathrm{eff}}\approx \frac{N}{\tau_{\mathrm{int}}}. $$例如保存了 $100\,000$ 次迭代,但 $\tau_{\mathrm{int}}=200$,对该统计量而言只相当于约 $500$ 个独立样本。有效样本量依赖 $h$:参数均值混合良好,不代表尾部概率或非线性预测量也混合良好。
$\widehat R$ 接近 $1$ 只说明所运行的多条链彼此相似。如果它们都困在同一个模式,指标仍可能偏乐观。可结合模型结构设置分散的初值,检查能够区分模式的统计量,并用模拟数据或低维基准分布验证采样程序。
随机游走 Metropolis 对双峰混合正态分布抽样。改变 proposal 步长,观察跨越两个模式的能力。
目标分布左右各占一半。接受率正常仍不保证跨峰充分,需同时看轨迹和有效样本量。
2.3 如何模拟 Brownian 路径
用独立增量生成网格路径
标准 Brownian motion $W_t$ 满足 $W_0=0$,增量独立,并且
$$ W_t-W_s\sim N(0,t-s),\qquad 0\le s\lt t. $$在网格 $t_n=nh$ 上,因此只需递推
$$ W_{t_{n+1}} =W_{t_n}+\sqrt h\,Z_n, \qquad Z_n\overset{\mathrm{iid}}{\sim}N(0,1). $$多维 Brownian motion 对每一维生成独立标准正态增量;若要求相关性 $\Sigma$,则用 $\sqrt h\,AZ_n$,其中 $AA^\mathsf T=\Sigma$。网格之间可作线性插值以便绘图,但插值线段本身并不是 Brownian 路径。
递推式之所以正确,是因为网格值的协方差满足 Brownian motion 的定义。对 $i\le j$,
$$ \begin{aligned} \operatorname{Cov}(W_{t_i},W_{t_j}) &=\operatorname{Var}\!\left( \sum_{k=0}^{i-1}\Delta W_k \right)\\ &=\sum_{k=0}^{i-1}h =t_i =\min(t_i,t_j). \end{aligned} $$所有网格值都是独立正态增量的线性组合,因此具有正确的联合高斯分布。若把每个 $W_{t_n}$ 分别生成为 $N(0,t_n)$,边际分布虽然正确,时间协方差却会丢失。
Brownian bridge 与多尺度细化
如果已经知道区间两端 $W_s=a,W_t=b$,中点的条件分布为
$$ W_{(s+t)/2}\mid(W_s=a,W_t=b) \sim N\!\left( \frac{a+b}{2},\frac{t-s}{4} \right). $$递归加入中点可构造 Brownian bridge,也能在保留粗网格增量的同时细化路径。这种耦合在 multilevel Monte Carlo 中很重要:细层的两个增量相加必须等于对应的粗层增量。
中点条件分布可由联合正态条件公式得到。令
$$ M=W_{(s+t)/2}-W_s,\qquad R=W_t-W_{(s+t)/2}. $$$M,R$ 独立且都服从 $N(0,(t-s)/2)$。在已知 $M+R=b-a$ 后,对称性给出条件均值 $(b-a)/2$,条件方差则由两个独立正态之和的条件分布得到 $(t-s)/4$。加回 $a$ 就得到 bridge 公式。
Lévy–Ciesielski 展开给出另一种构造:
$$ W_t=tZ_0+\sum_{j=0}^{\infty} \sum_k Z_{j,k}\,\psi_{j,k}(t), $$其中 $Z_0,Z_{j,k}$ 独立标准正态,$\psi_{j,k}$ 是积分后的 Haar 小波,也称 Schauder 帐篷函数。截断层数给出连续、分层的近似;增加一层只补充更细尺度的随机波动。这种表示适合理解 Brownian 路径的多尺度结构,而固定网格增量法通常更适合直接驱动 Euler–Maruyama。
路径正则性与数值检查
Brownian 路径几乎处处连续,却几乎处处不可微;任意 $\alpha\lt1/2$ 时路径具有 $\alpha$-Hölder 正则性,而 $\alpha\ge1/2$ 时一般不成立。它的二次变差满足
$$ \sum_n \bigl(W_{t_{n+1}}-W_{t_n}\bigr)^2 \longrightarrow T. $$因此普通微积分的高阶小量规则不再适用,Itô 公式中会出现二阶修正项。比较粗细网格时,应复用同一组 Brownian 增量,使差异主要来自时间离散。
实现时可同时保留路径和增量,供后面的 SDE 模拟使用:
def brownian_path(t_final, steps, paths, rng):
    h = t_final / steps
    d_w = np.sqrt(h) * rng.standard_normal((paths, steps))
    w = np.column_stack((np.zeros(paths), np.cumsum(d_w, axis=1)))
    return w, d_w
若需要比较步长 $h$ 和 $2h$,不应重新生成粗网格路径,而应令
$$ \Delta W_n^{(2h)} =\Delta W_{2n}^{(h)}+\Delta W_{2n+1}^{(h)}. $$粗细路径因而共享同一噪声,观察到的差主要来自离散格式。
从独立增量 $\Delta W_n\sim N(0,h)$ 累加路径,并计算离散二次变差。
增加步数时,单条路径会改变细节;离散二次变差应围绕 $T$ 波动。
3. 随机微分方程:从模型到数值解
3.1 SDE 的定义、解与模型
如何理解 SDE 的解
一个 Itô 型 SDE 写成
$$ dX_t=\mu(X_t)\,dt+\sigma(X_t)\,dW_t, \qquad X_0=\xi. $$它的含义是积分方程
$$ X_t =\xi+\int_0^t\mu(X_s)\,ds +\int_0^t\sigma(X_s)\,dW_s. $$$\mu$ 是漂移,描述平均方向;$\sigma$ 是扩散,控制随机波动。解必须适应给定信息流并满足积分可积性。若 $\mu,\sigma$ 全局 Lipschitz 且初值有适当矩,SDE 存在路径意义下唯一的强解;局部 Lipschitz 主要保证爆炸前的唯一性,还需额外条件排除有限时爆炸。
“强解”和后面的“强误差”含义不同。强解建立在给定 Brownian motion 和过滤上,可视为初值与驱动噪声的函数;弱解允许连概率空间和 Brownian motion 一起寻找。路径唯一性是说同一概率空间、同一噪声、同一初值下的两个解几乎必然一致。数值分析里的强收敛则比较近似解和精确解在同一噪声上的路径距离。
积分形式明确了 $dW_t$ 的含义:它是 Itô 积分的积分元,并非普通的“无穷小正态变量”。被积函数在时刻 $t$ 只能使用当时已有的信息;Euler–Maruyama 采用左端点取值,正是沿用了这一约定。
常见模型与 Itô 修正
常见模型可以从系数直接读出:
| 模型 | SDE | 主要特征 |
|---|---|---|
| 几何 Brownian motion | $dS_t=\mu S_tdt+\sigma S_tdW_t$ | 保持正值,有显式解 |
| Ornstein–Uhlenbeck | $dX_t=\kappa(\theta-X_t)dt+\sigma dW_t$ | 均值回复,高斯 |
| CIR | $dV_t=\kappa(\theta-V_t)dt+\xi\sqrt{V_t}\,dW_t$ | 非负状态,扩散非全局 Lipschitz |
几何 Brownian motion 的显式解是
$$ S_t =S_0\exp\!\left[ \left(\mu-\frac12\sigma^2\right)t+\sigma W_t \right]. $$指数中的 $-\sigma^2/2$ 来自 Itô 公式:
$$ df(X_t) =f'(X_t)\,dX_t +\frac12f''(X_t)\sigma(X_t)^2\,dt. $$二阶修正项区分了 Itô 公式和普通链式法则。显式可解模型还可作为数值基准:在相同 Brownian 路径上比较精确解和近似解,就能测量强误差。
以 $f(x)=\log x$ 应用于几何 Brownian motion 为例,
$$ f'(x)=\frac1x,\qquad f''(x)=-\frac1{x^2}. $$所以
$$ \begin{aligned} d\log S_t &=\frac1{S_t}dS_t -\frac12\frac1{S_t^2}\sigma^2S_t^2\,dt\\ &=\left(\mu-\frac12\sigma^2\right)dt+\sigma\,dW_t. \end{aligned} $$积分后立即得到显式解。二阶项的量级没有消失,是因为 Brownian increment 满足 $(\Delta W)^2$ 的量级为 $\Delta t$。记忆式写法
$$ (dW_t)^2=dt,\qquad dW_t\,dt=0,\qquad (dt)^2=0 $$可以帮助计算,但严格依据是二次变差和 Itô 公式。
精确模拟几何 Brownian motion。固定 seed 后分别调整 $\mu$ 和 $\sigma$,可区分趋势与波动。
显示的是一条路径;解析期望 $S_0e^{\mu T}$ 是重复抽样的平均,不是单路径终值。
3.2 如何离散 SDE
Euler–Maruyama 方法
令 $t_n=nh$,$\Delta W_n=W_{t_{n+1}}-W_{t_n}\sim N(0,h)$。Euler–Maruyama 方法冻结一个时间步内的系数:
$$ Y_{n+1} =Y_n+\mu(Y_n)h+\sigma(Y_n)\Delta W_n. $$该更新可从积分式得到。精确解在一个时间步上满足
$$ X_{t_{n+1}} =X_{t_n} +\int_{t_n}^{t_{n+1}}\mu(X_s)\,ds +\int_{t_n}^{t_{n+1}}\sigma(X_s)\,dW_s. $$用左端点 $X_{t_n}$ 冻结两个被积函数,并以 $Y_n$ 替代未知的 $X_{t_n}$,便有
$$ \int_{t_n}^{t_{n+1}}\mu(X_s)\,ds \approx\mu(Y_n)h, \qquad \int_{t_n}^{t_{n+1}}\sigma(X_s)\,dW_s \approx\sigma(Y_n)\Delta W_n. $$因此算法只需要生成正态增量,而不需要在每一步计算随机积分。
强误差与弱误差
它与确定性 Euler 法的外形相似,但误差受 Brownian 路径只有约 $1/2$ 阶正则性限制。在常见光滑和全局 Lipschitz 条件下,
$$ \bigl(\mathbb E|X_T-Y_N|^2\bigr)^{1/2}=O(h^{1/2}), $$而对足够光滑的测试函数 $\varphi$,
$$ \left| \mathbb E[\varphi(X_T)] -\mathbb E[\varphi(Y_N)] \right|=O(h). $$前者是强误差,关心同一路径上的距离;后者是弱误差,只关心分布经过测试函数后的期望。路径依赖量、停止时刻和障碍事件通常更依赖强近似;欧式期权价格等期望问题常以弱误差为主。
常见误差概念可以放在同一张表中:
| 误差 | 典型形式 | 回答的问题 |
|---|---|---|
| 终点强误差 | $(\mathbb E\lvert X_T-Y_N\rvert^p)^{1/p}$ | 同一噪声下终值相差多少 |
| 一致强误差 | $(\mathbb E[\sup_{t\le T}\lvert X_t-\bar Y_t\rvert^p])^{1/p}$ | 整条路径最坏相差多少 |
| 弱误差 | $\lvert\mathbb E\varphi(X_T)-\mathbb E\varphi(Y_N)\rvert$ | 目标期望偏差多少 |
| 几乎必然误差 | 单条耦合路径随 $h\to0$ 的误差 | 固定样本点上是否收敛 |
弱阶依赖测试函数的光滑性。数字期权一类不连续 payoff、首次越界时间和路径最大值可能达不到光滑终值函数的理论阶数,需要平滑、Brownian bridge 校正或针对性的误差分析。
更高阶和保结构格式
标量噪声下,Milstein 方法加入一次 Itô–Taylor 修正:
$$ Y_{n+1} =Y_n+\mu(Y_n)h+\sigma(Y_n)\Delta W_n +\frac12\sigma(Y_n)\sigma'(Y_n) \bigl((\Delta W_n)^2-h\bigr). $$在合适条件下,其强收敛阶提高到 $1$。多维非交换噪声还需要模拟迭代随机积分,实现难度会明显增加。
上述收敛阶依赖系数的正则性假设。超线性漂移可能使显式 Euler 的矩发散;CIR 一类模型也可能被离散步骤推到负值。针对这些结构,可改用漂移隐式、tamed、截断或保正格式。数值实验还需比较
$$ h,\quad h/2,\quad h/4, $$并复用嵌套的 Brownian 增量,以区分离散误差与抽样噪声。
如何验证离散格式
以几何 Brownian motion 为测试模型,可以在同一个终点增量 $W_T$ 上计算精确解和 Euler 近似:
def gbm_euler(s0, mu, sigma, dt, d_w):
    s = np.full(d_w.shape[0], s0, dtype=float)
    for n in range(d_w.shape[1]):
        s += mu * s * dt + sigma * s * d_w[:, n]
    return s

exact = s0 * np.exp((mu - 0.5 * sigma**2) * t_final
                    + sigma * d_w.sum(axis=1))
strong_rmse = np.sqrt(np.mean((exact - approx)**2))
对一系列 $h$ 作 $\log(\text{error})$ 对 $\log h$ 的回归,斜率应接近理论强阶。每个步长都复用细网格增量,并给误差估计配上 Monte Carlo 误差条;否则随机波动可能掩盖真正的收敛斜率。
两条曲线复用相同 Brownian increments,从而把路径差异集中在时间离散上。
固定 seed 并逐步增加步数,可观察终点强误差怎样变化。
3.3 如何计算 SDE 期望
离散偏差与抽样误差
数值计算的目标通常不是一条路径本身,而是
$$ Q=\mathbb E[\varphi(X_T)] \quad\text{或}\quad Q=\mathbb E\!\left[ \Phi((X_t)_{0\le t\le T}) \right]. $$若 $X_T$ 无法精确采样,先以步长 $h$ 得到离散终值 $Y_T^{(h)}$,再模拟 $M$ 条独立路径:
$$ \widehat Q_{M,h} =\frac1M\sum_{i=1}^M \varphi\!\left(Y_T^{(h,i)}\right). $$总误差分成离散偏差和抽样波动:
$$ \widehat Q_{M,h}-Q= \underbrace{ \widehat Q_{M,h} -\mathbb E[\varphi(Y_T^{(h)})] }_{\text{Monte Carlo 误差}} + \underbrace{ \mathbb E[\varphi(Y_T^{(h)})] -\mathbb E[\varphi(X_T)] }_{\text{离散偏差}}. $$若弱阶为 $\alpha$,其 RMSE 典型地满足
$$ \operatorname{RMSE} \lesssim C_1M^{-1/2}+C_2h^\alpha. $$因此只增加路径数不能消除离散偏差,只减小步长也不能压低 Monte Carlo 噪声。若目标误差为 $\varepsilon$,可先取 $h^\alpha\asymp\varepsilon$,再取 $M\asymp\varepsilon^{-2}$;最后用样本方差报告标准误,并用至少两个步长估计偏差。
如何分配计算预算
在固定 $h$ 后,令
$$ V_h=\operatorname{Var}(\varphi(Y_T^{(h)})). $$抽样部分的标准误估计为
$$ \widehat{\operatorname{SE}} =\sqrt{\frac{\widehat V_h}{M}}, $$所以可以先做少量 pilot paths 估计 $V_h$,再反推出达到目标统计误差所需的 $M$。如果一条 Euler 路径需要 $T/h$ 次更新,总成本约为
$$ \operatorname{Cost}\asymp M h^{-1}. $$在 Euler 弱阶 $\alpha=1$ 的理想情形下,$h\asymp\varepsilon$、$M\asymp\varepsilon^{-2}$,普通 Monte Carlo Euler 的成本约为 $\varepsilon^{-3}$。路径数与时间步长需要在同一误差预算下共同选择。
用几何 Brownian motion 校准误差
以几何 Brownian motion 和线性 payoff $\varphi(x)=x$ 为例,
$$ \mathbb E[S_T]=S_0e^{\mu T}. $$可据此检查:
- Monte Carlo Euler 估计是否接近解析期望;
- 固定 $h$ 增加 $M$ 时,区间宽度是否按 $M^{-1/2}$ 收缩;
- 让 $h$ 减半时,估计均值相对解析值的偏差是否按预期下降。
若只看第一个条件,抽样误差和离散偏差可能恰好相互抵消,给出虚假的准确结果。
Multilevel Monte Carlo
Multilevel Monte Carlo 用恒等式
$$ \mathbb E[P_L] =\mathbb E[P_0] +\sum_{\ell=1}^L \mathbb E[P_\ell-P_{\ell-1}] $$代替只在最细网格上取平均,其中 $P_\ell=\varphi(Y_T^{(h_\ell)})$。相邻层使用耦合的 Brownian 增量。随着层数增加,$P_\ell-P_{\ell-1}$ 的方差下降,因此昂贵的细层只需少量样本,便宜的粗层承担大部分抽样。MLMC 的收益取决于离散偏差、层差方差和单条路径成本随层数变化的速度。
写
$$ V_\ell=\operatorname{Var}(P_\ell-P_{\ell-1}), \qquad C_\ell=\text{生成一个耦合层差的成本}. $$在总方差约束
$$ \sum_{\ell=0}^L\frac{V_\ell}{M_\ell} \le \frac{\varepsilon^2}{2} $$下最小化成本 $\sum_\ell M_\ell C_\ell$,得到分配规律
$$ M_\ell\propto \sqrt{\frac{V_\ell}{C_\ell}}. $$细层的 $C_\ell$ 大,但耦合良好时 $V_\ell$ 很小,所以 $M_\ell$ 快速下降。预实验用于估计各层的 $V_\ell$ 和 $C_\ell$,再按上述比例分配样本。若粗细路径独立生成,层差方差不会随 $\ell$ 有效下降,MLMC 的优势也随之消失。
MLMC 的实现通常按以下顺序进行:
- 用显式解或极细网格验证单路径更新;
- 固定耦合方式,测量层差均值和方差;
- 选择最大层 $L$ 控制偏差;
- 按各层方差和成本分配样本数;
- 分别报告置信区间与剩余离散偏差。
用 Euler–Maruyama 估计 $\mathbb E[S_T]$,同时报告置信区间并与解析期望比较。
增加路径数主要缩小置信区间;增加每条路径的步数主要减小离散偏差。
3.4 如何模拟随机跳跃
Lévy 过程如何描述跳跃
Brownian motion 只有连续路径,无法表示突然到达的冲击。Lévy process $L_t$ 具有平稳独立增量和 càdlàg 路径,其特征函数写成
$$ \mathbb E[e^{iuL_t}] =\exp\{t\psi(u)\}, $$其中一维 Lévy–Khintchine 指数为
$$ \psi(u) =ibu-\frac12\sigma^2u^2 +\int_{\mathbb R\setminus\{0\}} \left( e^{iuz}-1-iuz\,\mathbf 1_{\{|z|\le1\}} \right)\nu(dz). $$三部分分别对应确定性漂移、Brownian 波动和跳跃测度 $\nu$。
Lévy measure 满足
$$ \int_{\mathbb R\setminus\{0\}} (1\wedge z^2)\,\nu(dz)\lt\infty. $$它不必是概率分布;$\nu(A)$ 表示单位时间内幅度落在 $A$ 中的平均跳数。当 $\nu(\mathbb R)\lt\infty$ 时,过程在有限区间只有有限个跳,称为 finite activity;当总质量无穷时,任意有限区间可能有无穷多个小跳。
复合 Poisson 过程
有限活动跳跃可从复合 Poisson 过程开始:
$$ L_t=\sum_{k=1}^{N_t}J_k, \qquad N_t\sim\operatorname{Poisson}(\lambda t). $$可以先生成区间内的跳跃数,再生成跳跃时刻和幅度;若只需要固定网格上的值,则直接模拟
$$ \Delta N_n\sim\operatorname{Poisson}(\lambda h), \qquad \Delta L_n=\sum_{k=1}^{\Delta N_n}J_{n,k}. $$若需要完整的事件时间,可按以下步骤生成:
- 生成指数等待时间 $E_k\sim\operatorname{Exp}(\lambda)$;
- 累加 $\tau_k=\tau_{k-1}+E_k$,直到超过 $T$;
- 对每个 $\tau_k\le T$ 生成独立幅度 $J_k$;
- 在 $\tau_k$ 处把路径增加 $J_k$。
这与先生成 $N_T\sim\operatorname{Poisson}(\lambda T)$,再把 $N_T$ 个时刻生成为 $[0,T]$ 上均匀变量的次序统计量等价。前者适合按时间推进,后者适合一次性生成整个区间。
跳扩散的离散化
对跳扩散
$$ dX_t =\mu(X_{t-})\,dt +\sigma(X_{t-})\,dW_t +\eta(X_{t-})\,dL_t, $$相应的 Euler 更新为
$$ Y_{n+1} =Y_n+\mu(Y_n)h +\sigma(Y_n)\Delta W_n +\eta(Y_n)\Delta L_n. $$$X_{t-}$ 表示跳跃前状态。若能精确生成跳跃时刻,可将它们加入跳跃自适应(jump-adapted)时间网格,避免把一个大跳摊到整段区间。
对 Poisson 过程还常使用补偿过程
$$ \widetilde N_t=N_t-\lambda t. $$它是均值为零的 martingale。因而
$$ \gamma\,dN_t =\gamma\lambda\,dt+\gamma\,d\widetilde N_t $$该分解把跳跃的平均效应和随机波动分开。不同教材可能把补偿项放入漂移,也可能保留原始 Poisson 积分;比较模型或实现公式时需先统一约定。
无限活动过程与小跳近似
当 $\nu(\mathbb R)=\infty$ 时,每个有限区间都可能包含无穷多个小跳,无法逐个生成。数值方法通常显式模拟大于阈值的跳,并将小跳截断、并入漂移,或在满足条件时用 Gaussian 项近似。Normal inverse Gaussian 等过程还可通过时间变换表示为
$$ L_t=\theta G_t+\sigma W_{G_t}, $$先生成 inverse Gaussian subordinator $G_t$,再条件生成正态增量。
如何检查跳跃模拟
截断阈值 $\delta$ 也引入一层误差。降低 $\delta$ 会增加每条路径需要模拟的跳数,却减少忽略小跳造成的偏差。此时总误差至少包含
$$ \text{抽样误差} +\text{时间离散误差} +\text{小跳截断或近似误差}. $$三者应分别通过增加样本数、细化时间网格和降低跳跃阈值来检查。如果同时改变三个参数,结果变好或变坏都无法定位原因。
验证时依次检查跳数的 Poisson 均值与方差、跳幅分布、增量的平稳独立性,以及时间步细化后目标统计量的稳定性。罕见大跳会使样本矩收敛很慢,可结合重要性采样或分层抽样。
可先用固定跳幅 $J_k\equiv j$ 测试程序。此时 $L_T=jN_T$,所以
$$ \mathbb E[L_T]=j\lambda T,\qquad \operatorname{Var}(L_T)=j^2\lambda T. $$复现这两个矩后,再换成随机跳幅,检查复合 Poisson 公式
$$ \mathbb E[L_T] =\lambda T\,\mathbb E[J], \qquad \operatorname{Var}(L_T) =\lambda T\,\mathbb E[J^2]. $$路径图只能显示单次实现,矩条件才能检验重复模拟的分布性质。
令 $L_T=jN_T$。上方画一条阶梯路径,同时用多次模拟检查终值的理论均值和方差。
增大 $\lambda T$ 会增加预期跳数;改变 $j$ 会按比例改变均值、按平方改变方差。
采样误差由有效样本量控制,时间离散误差由步长和格式控制;数值实验需要先判断当前由哪一项误差主导。